ASCII アートの生成
ASCII アートは、文字を並べて絵を表したものです。 文字は種類ごとに黒い画素の量も形も違うので、離れて見ると文字の並びがぼけて濃淡として見えます。 ハーフトーン化と同じく、この「ぼけ」をガウシアンフィルタでモデル化すると、良い ASCII アートとは
ぼかした文字の画像が元画像にできるだけ近い文字の並び
です。各マスにどの文字を置くかをバイナリ変数で表すと、この問題はそのまま QUBO になります。 ここで使う評価関数は、局所全探索で ASCII アートを生成する手法 [1] と同じものです。
QUBO 定式化
画像を縦 $16$ × 横 $8$ 画素のマスに区切り、$R$ 行 $C$ 列の各マスに文字を $1$ つ置きます。 文字は ! から ~ までの $94$ 種類で、空白は「どの文字も置かない」ことで表します。 文字の形には unscii-16 フォント($8 \times 16$ 画素、パブリックドメイン)を使います。
変数: $x_{r,c,k} \in \lbrace 0,1\rbrace$ は、$r$ 行 $c$ 列のマスに文字 $k$ を置くとき $1$ です。 変数は $R \times C \times 94$ の3次元配列になります。
制約: 1 つのマスに置ける文字は高々 $1$ つです:
\[\sum_{k} x_{r,c,k} \le 1 \qquad (0 \le r < R,\ 0 \le c < C)\]目的関数: 文字の黒い画素を $1$、白い画素を $0$ とした画像を $u$ とします。 ぼかした画像 $(G * u)$ の各画素の値は、その画素の「見かけの暗さ」です ($G$ は係数の総和が $256$ の $7 \times 7$ 整数ガウシアン、$\sigma = 2$)。 目標の暗さ $T$ は元画像の明るさ $I$ から決めます:
\[T(p) = \left\lfloor \frac{(I_{\max} - I(p))\, t_{\max}}{I_{\max} - I_{\min}} \right\rfloor, \qquad t_{\max} = \frac{256 \times 55}{128} = 110\]ここで $55$ は最も黒い画素が多い文字 N の黒画素数($16 \times 8 = 128$ 画素中)で、 $t_{\max}$ はその文字だけを敷き詰めたときの暗さです。 文字はそれ以上黒くできないので、元画像の最も暗い画素を $t_{\max}$ に、最も明るい画素を $0$(白)に対応させます。 最小化するのは、ぼかした文字の画像と目標の暗さの差の二乗和です:
和は画像に幅 $3$(フィルタ半径)の白い余白($T = 0$)を加えた範囲でとります。 文字のぼけが画像の外にはみ出した分も、白い紙の上の誤差として数えるということです。
途中で simplify して項数の爆発を防ぐ
$(G * u)(p)$ は変数の 1 次式なので、画素ごとに $(G * u)(p) - T(p)$ を組み立てて qbpp.sqr で二乗し、足し合わせれば $E(x)$ ができます(ハーフトーン化と同じ書き方です)。 ただし ASCII アートでは式が大きくなります。 $7 \times 7$ のフィルタ窓は最大 $4$ マスにかかり、各マスには $94$ 文字ぶんの変数があるので、1 画素の 1 次式は最大で数百項、二乗すると数万項になります。 しかも同じ変数の組が、近くの数十個の画素の二乗に繰り返し現れます。 全部の画素の二乗を足してから最後に 1 回だけ simplify すると、簡約前の項は最終的な項数の約 $70$ 倍に膨らみます。
そこで、式を部分ごとに作って simplify し、同じ項をまとめて小さくしてから足し合わせます:
- 1 画素の 1 次式は $49$ 個の $u$ の和で、同じ変数が何度も現れるので、二乗する前に
simplify()でまとめます。 - 二乗した式は画素 $16$ 行(文字 1 行ぶん)ごとに足し合わせ、
simplify_as_binary()で小さくしてからfに加えます。同じ文字の行の中で重複していた項は、ここでまとまります。 - 最後に
f全体をsimplify_as_binary()して、隣り合う文字の行の境目で重複した項をまとめます。
$16$ 行 $32$ 列($256 \times 256$ 画素)の例での実測です(C++ 版、64 コアの CPU):
| simplify のしかた | 構築時間 | 最大メモリ |
|---|---|---|
| 全画素の二乗を足してから最後に 1 回 | 60 秒 | 28.7 GB |
| 画素 1 行ごと | 104 秒 | 5.8 GB |
| 画素 16 行(文字 1 行)ごと | 59 秒 | 2.4 GB |
途中で simplify しても項を作る手間は同じなので、時間はほとんど変わりませんが、メモリは約 $1/12$ になります。 細かく区切りすぎると simplify の回数が増えて遅くなるので、重複がまとまりやすい「文字 1 行」がちょうどよい区切りです。
Python 版の構築は、文字 1 行ごとに simplify する書き方で約 $1.5$ 分(import pyqbpp.c32e64m2 で項の次数を 2 までに固定すると約 $40$ 秒)です(32 コアの CPU)。
PyQBPP プログラム
以下のプログラムは、$256 \times 256$ 画素の合成グレースケール画像(対角グラデーション + 明るい円)を $16$ 行 $32$ 列の ASCII アートに変換して表示します。前半の FONT は文字の形のデータです:
import pyqbpp as qbpp

FH, FW = 16, 8                   # 文字の大きさ(縦 16 × 横 8 画素)
NC = 94                          # 文字の種類('!'〜'~'。空白は「文字なし」で表す)
R, C = 16, 32                    # 文字の行数と列数
ROWS, COLS = R * FH, C * FW      # 画像の大きさ(256 × 256 画素)
M = 3                            # フィルタ半径(7x7 フィルタ)
G = [[1, 2, 3, 4, 3, 2, 1],
     [2, 4, 7, 7, 7, 4, 2],
     [3, 7, 10, 11, 10, 7, 3],
     [4, 7, 11, 12, 11, 7, 4],
     [3, 7, 10, 11, 10, 7, 3],
     [2, 4, 7, 7, 7, 4, 2],
     [1, 2, 3, 4, 3, 2, 1]]      # 整数ガウシアン(σ = 2、総和 256)

# unscii-16 フォント(パブリックドメイン): 1 文字 16 行 × 8 ビット、'!'〜'~'
FONT = [
    "00181818181818181800001818000000", "00666666000000000000000000000000",
    "00006C6C6CFE6C6C6CFE6C6C6C000000", "0018183C666030180C06663C18180000",
    "000006C6CCCC181830306666C6C00000", "0000386C6C38307ADECCCCCC76000000",
    "00181818300000000000000000000000", "000C18183030303030303018180C0000",
    "003018180C0C0C0C0C0C0C1818300000", "0000000066663CFF3C66660000000000",
    "000000001818187E1818180000000000", "00000000000000000000381818306000",
    "000000000000007E0000000000000000", "00000000000000000000181818000000",
    "030306060C0C181830306060C0C00000", "0000386CC6C6CED6E6C6C66C38000000",
    "0000183878181818181818187E000000", "00003C666606060C183060607E000000",
    "00003C666606061C060666663C000000", "00000C1C3C6CCCCCFE0C0C0C0C000000",
    "00007E6060607C06060666663C000000", "00001C3060607C66666666663C000000",
    "00007E0606060C0C1818181818000000", "00003C666666763C6E6666663C000000",
    "00003C666666663E0606060C38000000", "00000018181800000000181818000000",
    "00000018181800000000381818306000", "000000060C18306030180C0600000000",
    "00000000007E0000007E000000000000", "0000006030180C060C18306000000000",
    "003C6666060C18181800001818000000", "00007CC6C6C6DEDEDEDCC0C07C000000",
    "0000183C6666667E6666666666000000", "00007C6666666C786C6666667C000000",
    "00003C6666606060606066663C000000", "0000786C666666666666666C78000000",
    "00007E606060607C606060607E000000", "00007E6060607C606060606060000000",
    "00003C666660606E666666663E000000", "000066666666667E6666666666000000",
    "00007E1818181818181818187E000000", "0000060606060606060666663C000000",
    "0000C6C6CCCCD8F0D8CCCCC6C6000000", "0000606060606060606060607E000000",
    "0000C6EEEEFED6D6C6C6C6C6C6000000", "0000C6C6E6E6F6FEDECECEC6C6000000",
    "00003C6666666666666666663C000000", "00007C666666667C6060606060000000",
    "00003C6666666666666666663C0C0600", "00007C666666667C6C66666666000000",
    "00003C66666030180C0666663C000000", "00007E18181818181818181818000000",
    "0000666666666666666666663C000000", "0000666666666666663C3C1818000000",
    "0000C6C6C6C6C6D6D6FEEEEEC6000000", "0000C3C3663C1818183C66C3C3000000",
    "0000C3C366663C181818181818000000", "00007E06060C0C18303060607E000000",
    "003C30303030303030303030303C0000", "C0C06060303018180C0C060603030000",
    "003C0C0C0C0C0C0C0C0C0C0C0C3C0000", "0010386C6CC6C6000000000000000000",
    "000000000000000000000000000000FF", "0018180C060000000000000000000000",
    "0000000000003C063E6666663E000000", "0000606060607C66666666667C000000",
    "0000000000003C66606060663C000000", "0000060606063E66666666663E000000",
    "0000000000003C66667E60603C000000", "00001E3030307E303030303030000000",
    "0000000000003E66666666663E06067C", "0000606060607C666666666666000000",
    "0000181800007818181818181E000000", "00000C0C00000C0C0C0C0C0C0C0C0C78",
    "00006060606066666C786C6666000000", "0000781818181818181818181E000000",
    "000000000000CCFED6D6D6D6C6000000", "0000000000007C666666666666000000",
    "0000000000003C66666666663C000000", "0000000000007C66666666667C606060",
    "0000000000003E66666666663E060606", "0000000000007C666660606060000000",
    "0000000000003E60603C06067C000000", "0000003030307E30303030301E000000",
    "0000000000006666666666663E000000", "00000000000066666666663C18000000",
    "000000000000C6C6D6D6D67C6C000000", "000000000000C6C66C386CC6C6000000",
    "0000000000006666666666663E06063C", "0000000000007E060C1830607E000000",
    "000E1818181818F018181818180E0000", "18181818181818181818181818180000",
    "00E030303030301E3030303030E00000", "0072D69C000000000000000000000000",
]


def ink(k, y, x):
    # 文字 k('!' + k)の画素 (y, x) が黒なら 1
    return int(FONT[k][2 * y:2 * y + 2], 16) >> (7 - x) & 1


# 入力画像: 対角グラデーション + 明るい円(合成画像)
img = [[235 if (i - 85) ** 2 + (j - 170) ** 2 < 64 ** 2
        else 255 * (i + j) // (ROWS + COLS - 2) for j in range(COLS)]
       for i in range(ROWS)]

# 目標の暗さ T: 最も暗い画素 → 最も黒い文字の暗さ、最も明るい画素 → 0(白)。
# 画像の周りには幅 M の白い余白(T = 0)を付ける
max_ink = max(sum(ink(k, y, x) for y in range(FH) for x in range(FW))
              for k in range(NC))
t_max = 256 * max_ink // (FH * FW)
lo = min(min(row) for row in img)
hi = max(max(row) for row in img)
T = [[0] * (COLS + 2 * M) for _ in range(ROWS + 2 * M)]
for i in range(ROWS):
    for j in range(COLS):
        T[i + M][j + M] = (hi - img[i][j]) * t_max // (hi - lo)

# x[r][c][k] = 1: r 行 c 列に文字 k を置く
x = qbpp.var("x", R, C, NC)

# u[i][j]: 文字の画像の画素 (i, j) の黒さ(x の 1 次式)
u = [[0] * COLS for _ in range(ROWS)]
for i in range(ROWS):
    for j in range(COLS):
        for k in range(NC):
            if ink(k, i % FH, j % FW):
                u[i][j] += x[i // FH][j // FW][k]

# E = Σ((G * u) - T)^2。画素 FH 行(文字 1 行ぶん)ずつ組み立てて simplify し、f に足す
f = 0
for i0 in range(-M, ROWS + M, FH):
    g = 0
    for i in range(i0, min(i0 + FH, ROWS + M)):
        for j in range(-M, COLS + M):
            e = -T[i + M][j + M]  # (G * u)(i, j) - T(i, j)
            for a in range(2 * M + 1):
                for b in range(2 * M + 1):
                    if 0 <= i + a - M < ROWS and 0 <= j + b - M < COLS:
                        e += G[a][b] * u[i + a - M][j + b - M]
            e.simplify()  # 二乗する前に同じ変数をまとめる
            g += qbpp.sqr(e)
    g.simplify_as_binary()  # 同じ項をまとめて小さくしてから
    f += g                  # f に足す
# 1 マスに置ける文字は高々 1 つ(どの文字も置かなければ空白)
f += 2 * t_max * 256 * max_ink * qbpp.cons(qbpp.vector_sum(x) <= 1)
f.simplify_as_binary()

sol = qbpp.EasySolver(f).search(time_limit=10)
print("variables =", sol.info["var_count"], " terms =", sol.info["term_count"])
print("energy =", sol.energy)

# 解を文字に戻して表示
val = sol(x)
for r in range(R):
    line = ""
    for c in range(C):
        ch = " "
        for k in range(NC):
            if val[r][c][k]:
                ch = chr(ord("!") + k)
        line += ch
    print(line)
プログラムの流れは次のとおりです。
Tに目標の暗さを用意します(画像の周りに幅 $3$ の白い余白を付けます)。qbpp.var("x", R, C, NC)で $16 \times 32 \times 94$ の変数配列を作ります。u[i][j]は文字の画像の画素 $(i, j)$ の黒さで、その画素が黒になる文字の変数の和(xの 1 次式)です。- 画素ごとに $(G * u)(p) - T(p)$ を
eに組み立て、simplify()してからqbpp.sqr(e)をgに足します。 画素 $16$ 行ぶん足したらg.simplify_as_binary()で小さくしてfに加えます。 qbpp.vector_sum(x)は最後の軸(文字の種類)の和、つまり各マスに置いた文字の数の配列です。qbpp.cons(... <= 1)で「各マスに高々 1 文字」の制約をすべてのマスに課します。 2 文字目を重ねて減らせる誤差は高々 $2\, t_{\max} \cdot 256 \cdot 55$ なので(重ねた文字のぼけの合計は $256 \times$ 黒画素数)、 この値を重みにすれば、文字を重ねた解が得になることはありません。- 最後の
f.simplify_as_binary()で全体をまとめてEasySolverで解き、解sol(x)から各マスで値が $1$ の文字を拾って表示します。
出力結果
variables = 48128  terms = 13703866
energy = 40285185
QQSQ[KQQ$Q$Q$QIQ2X{%[%[%[%[%;%;%
CQ[KQQ$Q$Q$Q$X{X{X?"~"~^!E%;%;%j
[KQQ$Q$Q$Q$X{X3?"         "!%;%;
QQ$QIQ$Q$X{X{%~             '%;;
QQ$Q$Q$X{X{X]}               :;;
QQ$S$%{X{Xj5%L               :=:
[Q$X{%{XjX(%5;               :::
$O{G{X{Xj%[%[%;            _:=::
32X|X|%[%[%[%;%\__       _.=:=::
[X|X|%[%[%[%;%;%;;;=_=_=:=:==:=:
[X|%[%[%;%;%;%;%;;;;;=:::=::=:--
[%[%[%[%;%;Z;%;;;;;::=:=::=:-_-
[%[%;%;%;2;Z;;;;;=:=::::=:-_-
[%;%;%;%;Z;;;;;=:=:=::=:-_-
[%;%;%;%;;;;;=:=:=::=:-_-
;%;%;%:;=:=:=::=::=:---
変数は $48{,}128$ 個、simplify 後の QUBO は約 $1370$ 万項です。 EasySolver は乱択ヒューリスティックなので、得られる文字の並びとエネルギーは実行ごとに変わります。
入力画像(左)と、出力された文字を同じフォントで描いた画像(右):
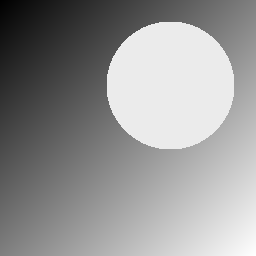
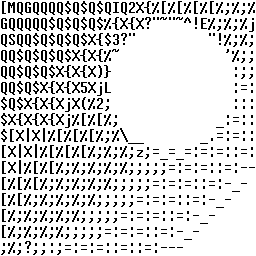
グラデーションが文字の濃さの変化で表され、円の縁には上側に " や ~、下側に _ のように、 縁の向きに沿った形の文字が選ばれています。 文字の平均的な濃さだけでなく、ぼかしたときの形まで元画像に合わせているためです。
実画像への適用
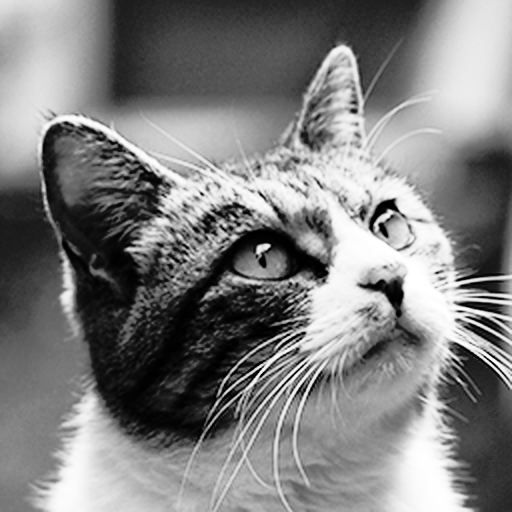
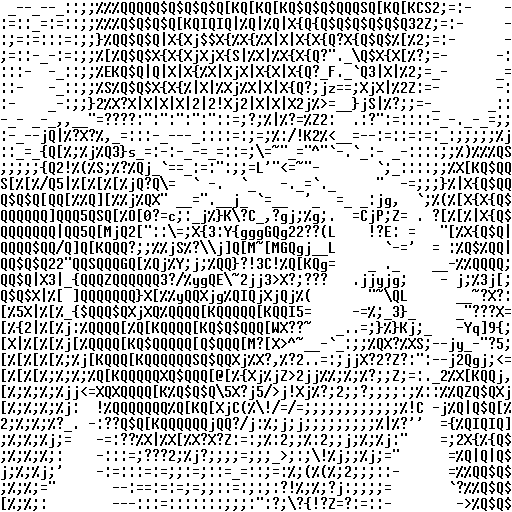
入力画像を生成している部分をファイル読み込みに差し替えて、$R$, $C$ を変えれば、実際の写真を ASCII アートにできます。 次の例は $512 \times 512$ 画素の写真を $32$ 行 $64$ 列の文字にしたものです (変数 $192{,}512$ 個・約 $5600$ 万項、EasySolver で $5$ 分探索)。 写真は暗い部分に画素が集中していたので、ヒストグラム平坦化で明るさをならしてから入力しています:
高速化: 項を直接求める
上のプログラムは数式どおりに画素ごとの二乗を展開するので、同じ項を何度も作ってからまとめています。 目的関数を先に手で展開し、各項の係数を整数で計算しておけば、QUBO の項を 1 回ずつ直接作れます。
方法
マス $(r, c)$ に文字 $k$ を置くと、ぼかした画像には「文字 $k$ を $G$ でぼかした $(16+6) \times (8+6)$ 画素の画像 $h_k$」が、そのマスの位置にずれて加わります。 $h_k$ はマスの位置によらず同じなので、マス $(r, c)$ の左上の位置を $p_{r,c}$ として
\[(G * u)(p) = \sum_{r,c,k} h_k(p - p_{r,c})\, x_{r,c,k}\]と書けます。これを $E(x)$ に代入して二乗を展開すると、次の形になります:
\[E(x) = \sum_{(r,c,k)} \sum_{(r',c',l)} A_{r'-r,\, c'-c}(k, l)\, x_{r,c,k}\, x_{r',c',l} \;-\; 2 \sum_{(r,c,k)} B_{r,c}(k)\, x_{r,c,k} \;+\; \sum_{p} T(p)^2\]- $A_{dr,dc}(k, l)$ は、$h_k$ と、$dr$ マス下・$dc$ マス右にずらした $h_l$ の重なり(同じ位置の画素値の積の和)です。 ぼけた文字は隣のマスまでしかはみ出さないので、$|dr| \le 1$, $|dc| \le 1$ 以外では $0$ です。 マスの位置によらないので、$9$ 通りのずれ × $94 \times 94$ の表を 1 回計算するだけで済みます。
- $B_{r,c}(k)$ は、マス $(r, c)$ に置いた $h_k$ と目標の暗さ $T$ の重なりです。
- 同じマスで $k = l$ の項 $x_{r,c,k}\, x_{r,c,k}$ は、
simplify_as_binary()が $x_{r,c,k}$ にまとめます。
プログラム
上のプログラムの x を宣言する行から最後の f.simplify_as_binary() までを、次のコードに置き換えます (FONT・ink、目標の暗さ T を作る部分、探索と表示の部分はそのままです):
# h[k]: 文字 k を G でぼかした画像((FH + 2M) × (FW + 2M) 画素)
HY, HX = FH + 2 * M, FW + 2 * M
h = [[[0] * HX for _ in range(HY)] for _ in range(NC)]
for k in range(NC):
    for y in range(FH):
        for x in range(FW):
            if ink(k, y, x):
                for a in range(2 * M + 1):
                    for b in range(2 * M + 1):
                        h[k][y + a][x + b] += G[a][b]

# A[dr, dc][k][l]: dr 行 dc 列ずらして置いた h[k] と h[l] の重なり
A = {}
for dr in (-1, 0, 1):
    for dc in (-1, 0, 1):
        ii = range(max(0, dr * FH), min(HY, HY + dr * FH))
        jj = range(max(0, dc * FW), min(HX, HX + dc * FW))
        A[dr, dc] = qbpp.array(
            [[sum(h[k][i][j] * h[l][i - dr * FH][j - dc * FW] for i in ii for j in jj)
              for l in range(NC)] for k in range(NC)])

# x[r][c][k] = 1: r 行 c 列に文字 k を置く
x = qbpp.var("x", R, C, NC)

# E = Σ A x x - 2 Σ B x + Σ T^2 の項を直接作る
f = sum(t * t for row in T for t in row)
for r in range(R):
    for c in range(C):
        for k in range(NC):
            # h[k] と T の重なり
            B = sum(h[k][i][j] * T[r * FH + i][c * FW + j]
                    for i in range(HY) for j in range(HX))
            f += -2 * B * x[r][c][k]
        for dr in (-1, 0, 1):
            for dc in (-1, 0, 1):
                if 0 <= r + dr < R and 0 <= c + dc < C:
                    f += qbpp.einsum("k,kl,l->", x[r][c], A[dr, dc],
                                     x[r + dr][c + dc])
# 1 マスに置ける文字は高々 1 つ(どの文字も置かなければ空白)
f += 2 * t_max * 256 * max_ink * qbpp.cons(qbpp.vector_sum(x) <= 1)
f.simplify_as_binary()
h[k]に、文字 $k$ の黒い画素ごとに $G$ を足し込んで、ぼかした文字の画像を作ります。A[dr, dc]に、ずらして置いた 2 つのぼけた文字の重なりを $94 \times 94$ の整数配列として計算します。- 定数項 $\sum T^2$ と 1 次の項 $-2 B_{r,c}(k)\, x_{r,c,k}$ を、係数を直接与えて
fに足します。 - 2 次の項 $\sum_{k,l} A_{dr,dc}(k, l)\, x_{r,c,k}\, x_{r+dr,c+dc,l}$ は、同じマスを含めて隣り合う $9$ マスの組ごとに、
qbpp.einsumで $94 \times 94$ 個まとめて作ります(x[r][c]はマス $(r, c)$ の $94$ 個の変数の 1 次元配列です)。 Python では項ごとのループが遅いので、まとめて作るほうが速くなります。
効果
できる QUBO は上のプログラムとまったく同じです(simplify 後の項数も同じ $13{,}703{,}866$ 項)。 項を 1 回ずつしか作らないので、構築時間は約 $1.5$ 分から約 $9$ 秒になります (import pyqbpp.c32e64m2 では約 $40$ 秒から約 $6$ 秒)。
数式どおりに書いた上のプログラムは読みやすく、目的関数を変えるのも簡単です。 項を直接求める方法は展開を手で導く手間がかかりますが、大きな問題では構築時間を大きく減らせます。
参考文献
[1] Y. Takeuchi, D. Takafuji, Y. Ito, and K. Nakano, “ASCII Art Generation Using the Local Exhaustive Search on the GPU,” Proc. International Symposium on Computing and Networking (CANDAR), pp. 194–200, 2013.